|
|
马上注册,结交更多好友,享用更多功能^_^
您需要 登录 才可以下载或查看,没有账号?立即注册
x
本帖最后由 yinda_peng 于 2026-9-19 14:15 编辑
NeurIPS 2025 | HEM:解耦 + 环境 Mixup,解决图异常检测中的结构分布偏移
Out-of-Distribution Generalized Graph Anomaly Detection with Homophily-aware Environment Mixup
一、问题背景
图异常检测(GAD)模型通常假设训练图和测试图来自同一分布。但现实中,结构分布偏移非常常见——比如训练集中的异常节点往往同配性高(邻居标签与自身一致),而测试集中的异常节点同配性低。
模型在高同配图上训练后,会学到一个偷懒的规则:直接拿邻居的多数标签来预测中心节点。这个规则在训练集上很有效,但到低同配的测试集上就失效了。论文把这种虚假模式称为 homophilic shortcut(同配性捷径)。
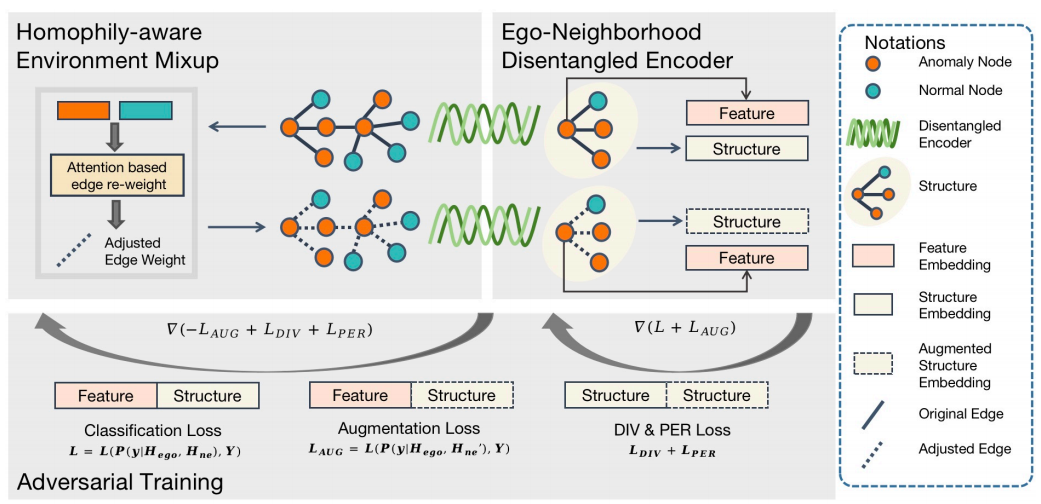
(原文 Figure 1)展示了整体框架:原始图经过同配性感知环境 Mixup 生成增强图,两者都送入 Ego-Neighborhood 解耦编码器,提取特征表示和结构表示,然后计算分类损失、增强损失、多样性损失和 PER 损失。
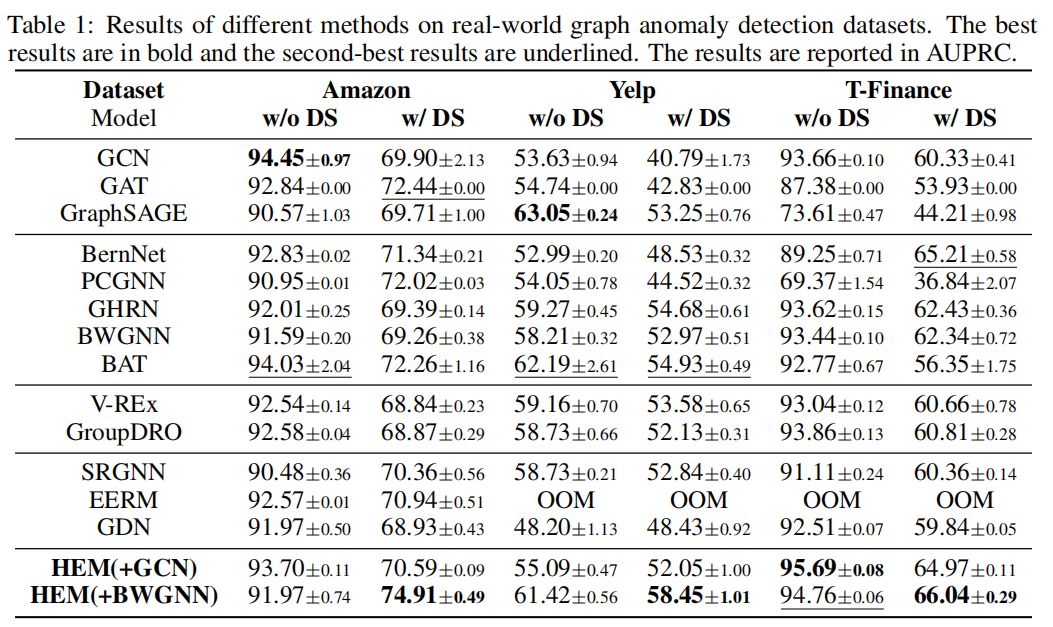
实验表明,基线方法在无偏移时表现良好,在有偏移时 AUPRC 下降 8%~33%(原文 Table 1)。
二、Ego-Neighborhood 解耦编码器
核心思想:把节点自身特征和邻域结构分开编码,避免结构分布偏移时特征表示被结构噪声污染。
2.1 邻域编码器
给定初始节点特征 X 和邻接矩阵 A,先用一个 MLP 投影到嵌入空间:
$H_0 = \mathrm{Proj}(X)$
然后计算邻域嵌入:
$H_{ne} = \mathrm{GNN}(H_0, A)$
论文采用 BWGN 作为邻域编码器,其嵌入可以写成:
$H_{ne} = \sum_{k=0}^{K} w_k \hat{A}^k H_0$
其中 $A_hat$ 是归一化邻接矩阵,$w_k$ 是 Beta 多项式系数。(原文公式 3-5)
2.2 Ego 编码器
Ego 编码器只编码节点自身特征,不聚合邻居,用 MLP 实现:
$H_{ego} = H_0 = \mathrm{Proj}(X)$
它与邻域编码器共享同一个投影器,确保嵌入在同一空间对齐。(原文公式 6)
2.3 对比预测
为了捕捉 ego 节点和邻域之间的差异(异常信号),用双线性函数预测异常概率:
$P(y \mid h_{ego}, h_{ne}) = \sigma(h_{ego}^T W h_{ne})$
其中 W 是可学习的权重矩阵,σ 是 sigmoid 函数。(原文公式 7)
这个设计的直觉是:异常节点之所以异常,往往是因为它和邻域的“差异”大。把 ego 和邻域解耦,才能把这个差异捕捉出来。
三、同配性感知环境 Mixup
目标:动态调整边权重,生成不同同配性的环境,让模型学不变模式。
3.1 边权重注意力
用注意力机制计算每条边的权重:
$w_{(u,v)} = \mathrm{sigmoid}\left(\mathrm{LeakyReLU}\left(\mathrm{concat}(h_{ego|u}, h_{ego|v})W\right)\right)$
其中 W 是可学习的注意力权重矩阵。$w_(u,v)$ 被归一化到 [0,1]。(原文公式 10)
与直接删边/加边相比,这种做法的优势是:
- 连续调制:可以平滑地改变结构;
- 内存高效:不需要存储多个稠密邻接矩阵;
- 同配性感知:根据边两端节点的特征调整权重,生成的环境更有意义。
3.2 增强图与损失
用调整后的边权重对图进行消息传递,得到增强的 ego 和邻域嵌入 $H'_ego$ 和 $H'_ne$,然后计算增强损失:
$L_{AUG} = \mathcal{L}(P(y \mid H'_{ego}, H'_{ne}), Y)$
其中 L 是交叉熵损失。(原文公式 11)
3.3 多样性损失与 PER 损失
为了保证生成的环境具有多样性,引入多样性损失:
$L_{DIV} = \mathrm{CosineSimilarity}(H_{ne}, H'_{ne})$
同时用 PER 损失约束扰动边比例,避免平凡解。(原文公式 12-13)
四、对抗训练框架
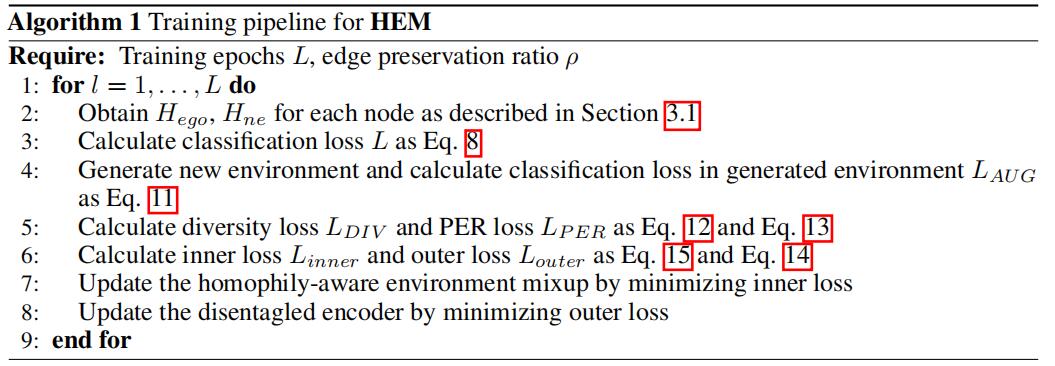
采用迭代对抗训练,外层训练编码器,内层训练环境 Mixup。
外层损失(训练编码器):
$L_{outer} = L + L_{AUG}$
其中 L 是原始图上的分类损失。(原文公式 14)
内层损失(训练环境 Mixup):
$L_{inner} = -L_{AUG} + L_{DIV} + L_{PER}$
这里 $-L_AUG$ 鼓励生成更具挑战性的环境,$L_DIV$ 增强多样性,$L_PER$ 约束扰动边比例。(原文公式 15)
训练过程交替优化外层和内层,原文 Algorithm 1 给出了完整流程。
五、理论分析
论文用简化例子证明了两个引理:
引理 1:最优预测系数 $α*(h)$ 显式依赖于同配性 h:
$\alpha^*(h) = \frac{\pi(1-\pi)(2h-1)}{\frac{h(1-h)}{d} + \pi(1-\pi)(2h-1)^2}$
训练时 $h_tr$ 和测试时 $h_te$ 不同,模型就会次优。(原文公式 18)
引理 2:如果 $|h_te - h_tr| ≤ ε$,通过环境 Mixup 和对抗训练,测试损失与最优损失的差距被下式约束:
$L(h_{te}, \alpha_{tr}^*) - L(h_{te}, \alpha_{te}^*) \leq V_{\max} L_f^2 \epsilon^2$
其中 $L_f$ 是 $f(h) = α_h*$ 的 Lipschitz 常数,$V_max$ 是方差上界。(原文公式 19)
也就是说,只要环境 Mixup 覆盖了测试时的同配性范围,模型就能泛化。
六、实验结果
- 数据集:Amazon、Yelp、T-Finance
- 指标:AUPRC、Recall@K
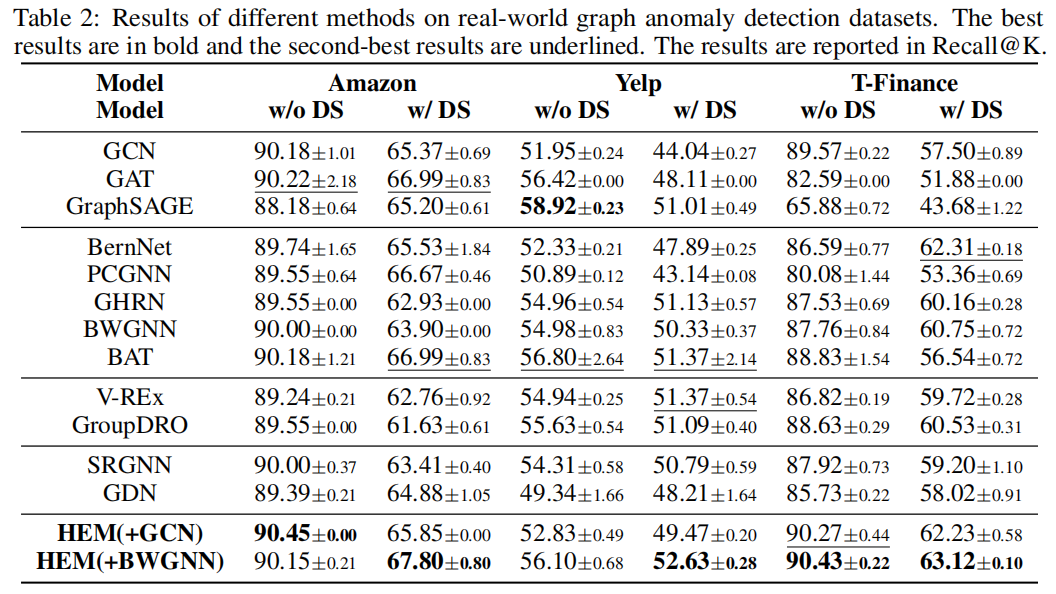
- 主要结果:HEM(+BWGNN) 在有偏移测试集上一致优于所有基线,Amazon 提升 3.4%,Yelp 提升 6.9%,T-Finance 提升 1.3%。(原文 Table 1 和 Table 2)
-
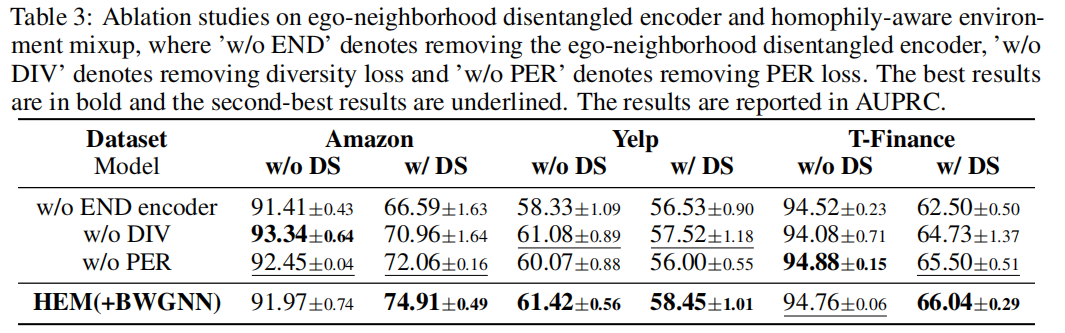
- 消融:去掉解耦编码器、多样性损失、PER 损失,性能均显著下降。(原文 Table 3)
-
论文链接:https://mn.cs.tsinghua.edu.cn/xinwang/PDF/papers/2025_Out-of-Distribution Generalized Graph Anomaly Detection with Homophily-aware Environment Mixup.pdf
代码:目前未公开
|
|
 18 鱼币
 ( 粤ICP备18085999号-1 | 粤公网安备 44051102000585号)


 狗仔卡
 发表于
 置顶卡
 千斤顶
 显身卡
 楼主
 发表于