|
|
马上注册,结交更多好友,享用更多功能^_^
您需要 登录 才可以下载或查看,没有账号?立即注册
x
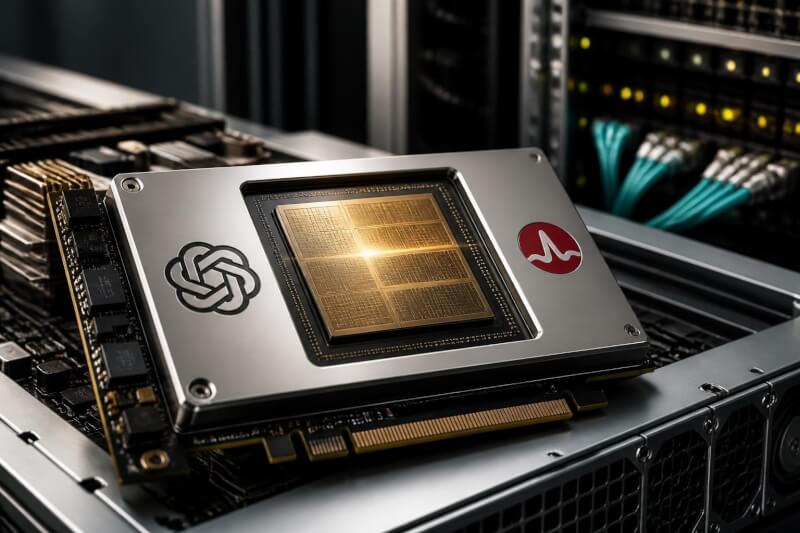
OpenAI 的第一颗自研 AI 芯片,终于拿出了实测成绩。
更有意思的是,这颗芯片不只是用来跑 AI,设计和编程过程中也大量使用了 AI —— 部分由 AI 生成的计算内核,甚至比人类芯片专家写的版本快了 1.5 至 1.8 倍。
这颗芯片名叫 Jalapeño,由 OpenAI 与博通合作开发,主要负责 “推理”,也就是模型训练完以后,真正回答用户问题、运行智能体和生成 Token 的过程。
它不能代替英伟达 GPU 训练下一代大模型,但可能帮 OpenAI 降低每天海量回答所产生的成本。
OpenAI 在公开的 InferenceX 基准上测试了 GPT‑OSS 120B、DeepSeek R1 和 Kimi K2.5。
按公司公布的数据,Jalapeño 在峰值负载下,每瓦可完成的 AI 工作量约为对比系统的 1.5 至 1.9 倍,端到端延迟低 1.7 至 3.6 倍。
对需要连续执行许多步骤的智能体来说,每一步少等一点,整项任务就可能快很多。
这颗芯片还有一层 “套娃”:OpenAI 称,AI 帮助团队探索电路实现、缩短验证周期,使芯片从设计到流片只用了九个月;后来又使用 Codex 为不同模型编写和优化程序。
被 AI 辅助设计的芯片,再运行 AI 生成的代码来服务 AI —— 这个闭环已经相当科幻了。
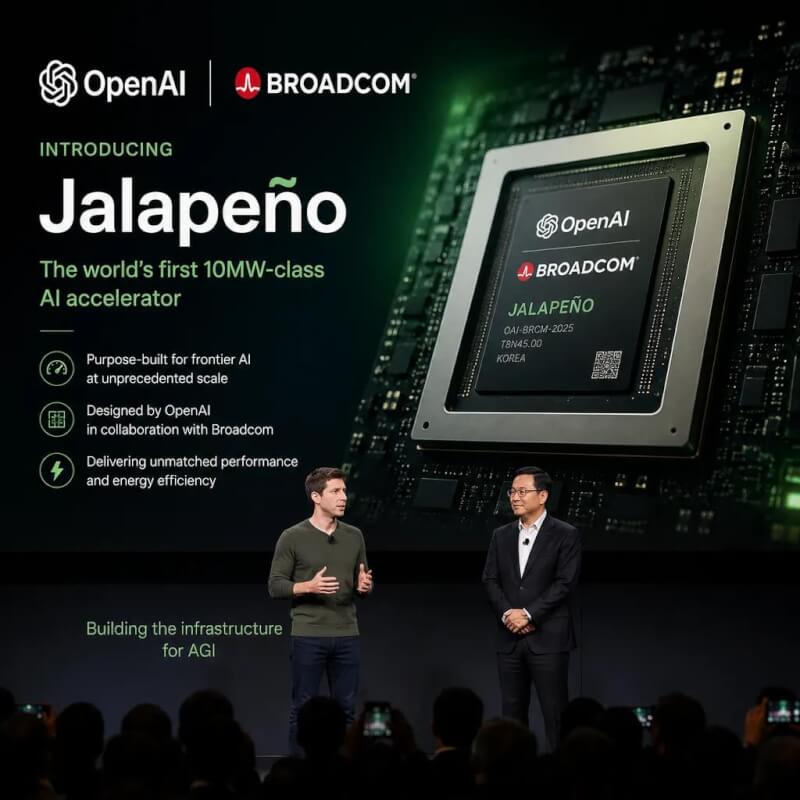
不过先别急着宣布 “英伟达输了”。
这些数据由 OpenAI 自己公布,比较时还使用了不同芯片的标称功耗,尚未经过大规模生产环境的长期独立验证;
1.5 至 1.8 倍的 “AI 胜人类” 也只针对部分计算模块,不代表整套模型都快了这么多。
Jalapeño 仍在进行量产资格验证,计划年底前开始部署。
真正值得聊的是:当 OpenAI 既做模型、又做软件、再自己造芯片,它可能逐渐掌握从一度电到一个 Token 的全部成本。
未来 AI 模型的护城河,会不会不再是参数量,而是谁能把每次回答做得更便宜?
|
|
 ( 粤ICP备18085999号-1 | 粤公网安备 44051102000585号)


 狗仔卡
 发表于 2026-8-27 05:21:20
 置顶卡
 千斤顶
 显身卡
 发表于 2026-8-27 05:21:35