|
|
悬赏10鱼币已解决
下面是小甲鱼爬豆瓣top250的代码,有两个个地方没看懂......求大佬解答
1.关于找出多少个页面那,没看懂depth会得到什么为什么要int
2.re模块是什么,速查手册里没有,下面好像也没看到使用
3.评分那怎么append(' 评分:%s '),不应该只要("评分:")吗
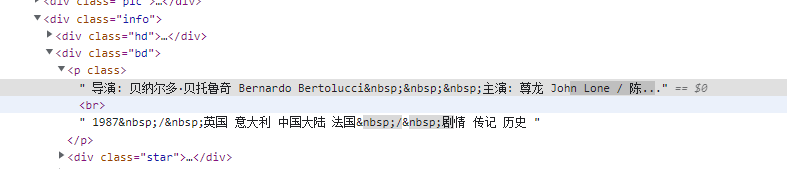
4.资料那个的分切没看懂怎么切的 网页源码在下面的图片里
问题有点多,大佬们挑不麻烦的回复一下吧
import requests
import bs4
import re
def open_url(url):
# 使用代理
# proxies = {"http": "127.0.0.1:1080", "https": "127.0.0.1:1080"}
headers = {'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/57.0.2987.98 Safari/537.36'}
# res = requests.get(url, headers=headers, proxies=proxies)
res = requests.get(url, headers=headers)
return res
def find_movies(res):
soup = bs4.BeautifulSoup(res.text, 'html.parser')
# 电影名
movies = []
targets = soup.find_all("div", class_="hd")
for each in targets:
movies.append(each.a.span.text)
# 评分
ranks = []
targets = soup.find_all("span", class_="rating_num")
for each in targets:
ranks.append(' 评分:%s ' % each.text)
# 资料
messages = []
targets = soup.find_all("div", class_="bd")
for each in targets:
try:
messages.append(each.p.text.split('\n')[1].strip() + each.p.text.split('\n')[2].strip())
except:
continue
result = []
length = len(movies)
for i in range(length):
result.append(movies + ranks + messages + '\n')
return result
# 找出一共有多少个页面
def find_depth(res):
soup = bs4.BeautifulSoup(res.text, 'html.parser')
depth = soup.find('span', class_='next').previous_sibling.previous_sibling.text
return int(depth)
def main():
host = "https://movie.douban.com/top250"
res = open_url(host)
depth = find_depth(res)
result = []
for i in range(depth):
url = host + '/?start=' + str(25 * i)
res = open_url(url)
result.extend(find_movies(res))
with open("豆瓣TOP250电影.txt", "w", encoding="utf-8") as f:
for each in result:
f.write(each)
if __name__ == "__main__":
main()
|
-
最佳答案
查看完整内容
1. 关于找出多少个页面的问题:在这个代码中,页面是通过在url中传入参数start来控制的,每页默认显示25条数据。在函数find_depth中,使用BeautifulSoup解析res.text得到soup对象,再通过soup.find()方法找到class为"next"的span标签,然后通过previous_sibling.previous_sibling属性找到该标签前面的兄弟标签,即包含总页数的标签,使用.text属性获得该标签中的文本内容,也就是总页数。但是,soup.find()方法返回的是一个Tag对象 ...
|

 狗仔卡
 发表于 2023-5-2 16:30:09
 置顶卡
 千斤顶
 显身卡
 发表于 2023-5-2 16:30:10